WatchOps-Lite
证据驱动的 OnCall 排障 Agent
让智能排障,
从合理推测走向证据。
把故障提问转化为有边界的诊断工作流。通过上下文治理、受控工具执行、证据约束和分层评测,提升诊断的可追溯性。
为什么做这个项目
OnCall 排查需要在服务、时间范围、指标、日志和调用链之间建立联系。直接让模型自由调用工具,容易出现参数不完整、上下文漂移、重复调用和无依据的判断。WatchOps-Lite 把这些问题拆成请求治理、执行边界、证据处理与质量评测四个部分。
单 Agent 诊断
通过固定 Eino Graph 和有预算的 ReAct 循环执行排查。
多 Agent 模式
由 AgentPlan 选择受限诊断角色,按独立入口执行。
评测与回放
按意图、检索、工具和证据分层检验,并重放失败案例。
从输入,到可检查的结果
- 01
治理当前请求
识别意图和关键参数,加载受控 Session Focus;当前输入优先,参数不足时先澄清。
- 02
准备诊断上下文
读取会话与持久记忆,按需检索知识库,将相关上下文组装到本轮请求。
- 03
受控工具取证
在步骤、调用、重试和总时间预算内执行只读工具,统一表达成功、降级或失败。
- 04
处理与引用证据
标准化并去重工具及检索结果,限制可用 Evidence ID,输出结论、引用、建议与局限性。
架构与职责划分
把不同的职责放在明确的边界内,让每一步的输入、输出和失败方式都可以单独理解。
Single-Agent 与 Multi-Agent 由独立入口选择;工具只读,系统不自动执行修复。
分层职责速览
核心工程实现
Turn Governance:当前输入优先与前置澄清
Single-Agent 与 Multi-Agent 复用同一套 Turn Governance。先加载有界 Session Focus,包含已确认 Slot、澄清状态、短摘要和至多六条近期非工具消息,再进行上下文意图识别。参数优先级为当前输入、命令值、已确认 Focus,明确的本轮更正不会被旧上下文覆盖。
关键 Slot 由确定性的 SlotRule 验证。服务名、时间范围缺失或指代不明时返回 Clarify,持久化本轮 Focus 后结束,不进入完整 Context、RAG、Agent 或工具。通过验证的 IntentDecision 才成为后续编排的执行依据。
固定 Eino Graph 与受控 ReAct 循环
单 Agent Graph 在验证通过后并行准备 Redis 上下文、确认过的 MySQL 长期记忆、用户画像、诊断 Skill Cards 和按意图启用的 Pre-RAG,再合并上下文、渲染 Prompt,由 Eino ReAct 决定运行时工具调用。意图识别只给出任务与建议,不直接执行工具。
Harness 限制步骤数、总工具调用、重试、重复调用、连续失败和总耗时,记录停止原因。模型输出可进行一次 JSON 修复,配置不完整、超时或输出无效时使用确定性回退;默认运行模式无需 LLM Key,真实 ReAct 路径通过配置显式启用。
Tool Runtime:原子只读工具与统一结果契约
query_metrics、query_logs、query_traces、query_alerts、get_service_topology 和 search_knowledge 通过统一工具契约进入 Runtime。运行时集中完成 Schema 校验、只读限制、超时、取消、错误归一化、脱敏与追踪,把 Prometheus、Elasticsearch、Jaeger 或可选 MCP 的差异封装在 Provider 后。
每次调用返回成功、降级或失败的规范化结果。Runtime 约束单次调用,Failure Controller 约束整个 Agent 循环;工具失败不能被包装成查询成功,系统也不自动执行修复命令。
Hybrid RAG 与按需 Multi-Query
知识检索统一进入 HybridRetrieve:BM25 为基础,可配置 Elasticsearch 向量召回,融合后进行去重与重排。Single-Agent Pre-RAG 按意图选择跳过、单查询或多查询;复杂因果链、多症状及长复合故障描述才需要扩展查询,普通指标、日志、Trace 或简单知识请求保持单查询。
多查询分别召回,再加权合并、去重并截取 Top-K;规划失败或结果不可用时回退到单查询。向量不可用可回退 BM25,外部重排失败可回退规则重排并记录原因。Pre-RAG 提供排查背景,证明本次故障仍需本轮实际观测证据。
Evidence Processor 与引用白名单
工具和检索结果进入 Evidence Processor,完成标准化、去重、打分、排序和分组,并分配 citation_id 元数据。输出主张所引用的原始 Evidence ID 必须存在于本轮真实执行结果的 Allowlist 中。
最终响应拆分结论、证据、推断、建议、局限性、工具执行和请求元数据。没有证据覆盖的假设不能变成已确认根因;数据源降级或时间范围不完整时,缺失范围进入 limitations,方便用户判断结论适用程度。
3+1 诊断角色与确定性 Fan-in
Multi-Agent 使用独立 API 入口。AgentPlan 选择 Triage、Evidence、Knowledge 和 Synthesis 角色及工具能力;Triage 给出排查计划与候选假设,Evidence 收集指标、日志和调用链,Knowledge 提供 Runbook 与确认过的记忆,Synthesis 负责最终结论。
角色在固定 Graph 中返回类型化结果,未选角色返回 skipped。共享 Pre-RAG 只执行一次,再按角色分配上下文;稳定 Fan-in 去重证据、合并局限性并评估假设,Synthesis 只能使用合并后的引用白名单。角色计划不能改写已验证的服务与时间参数。
分层记忆、版本 CAS 与可复现评测
Redis 将近期原始消息、Rolling Summary 与当前 Session Focus 分开管理,共享配置的 TTL。Summary / Focus 以单调版本号配合 WATCH / MULTI CAS 更新,避免较早请求晚完成后覆盖较新的会话状态。MySQL 保存确认后的长期记忆;持久化冲突只降低记忆保存能力,不替换已完成的诊断。
离线 Harness 分层检查 Intent / Slot、Clarify、Recall@5、MRR、工具选择与参数、Evidence 覆盖、引用和回退。失败检查形成稳定 Bad Case,用回放比较已修复、仍失败和新失败。真实模型评测显式启用,与无需外部模型及观测服务的确定性评测区分记录。
技术难点与设计取舍
为什么澄清发生在工具执行前?
如果服务名或时间范围不确定,再多查询也可能只是在错误对象上收集证据。把关键 Slot 校验前置,可减少无效调用,并避免历史上下文覆盖本轮明确输入。
为什么需要统一 Tool Runtime?
不同数据源的失败方式和响应结构不同。统一运行时集中约束参数、超时与调用预算,并把结果归一化,便于 Agent 处理降级,也方便复现执行过程。
为什么证据引用需要 Allowlist?
模型生成的来源标记不一定对应真实查询。只允许引用本次工作流产生的 Evidence ID,可以在输出阶段检查来源;证据不足时,结果明确表达缺失范围。
为什么把确定性评测与真实模型评测分开?
确定性离线 Harness 能稳定复现路由、参数、工具和证据问题。真实模型评测显式启用,用于检查模型行为;两者的成本、依赖和结论范围不同。
项目实景
以下截图来自实际运行的项目界面。点击图片可打开原图查看细节。
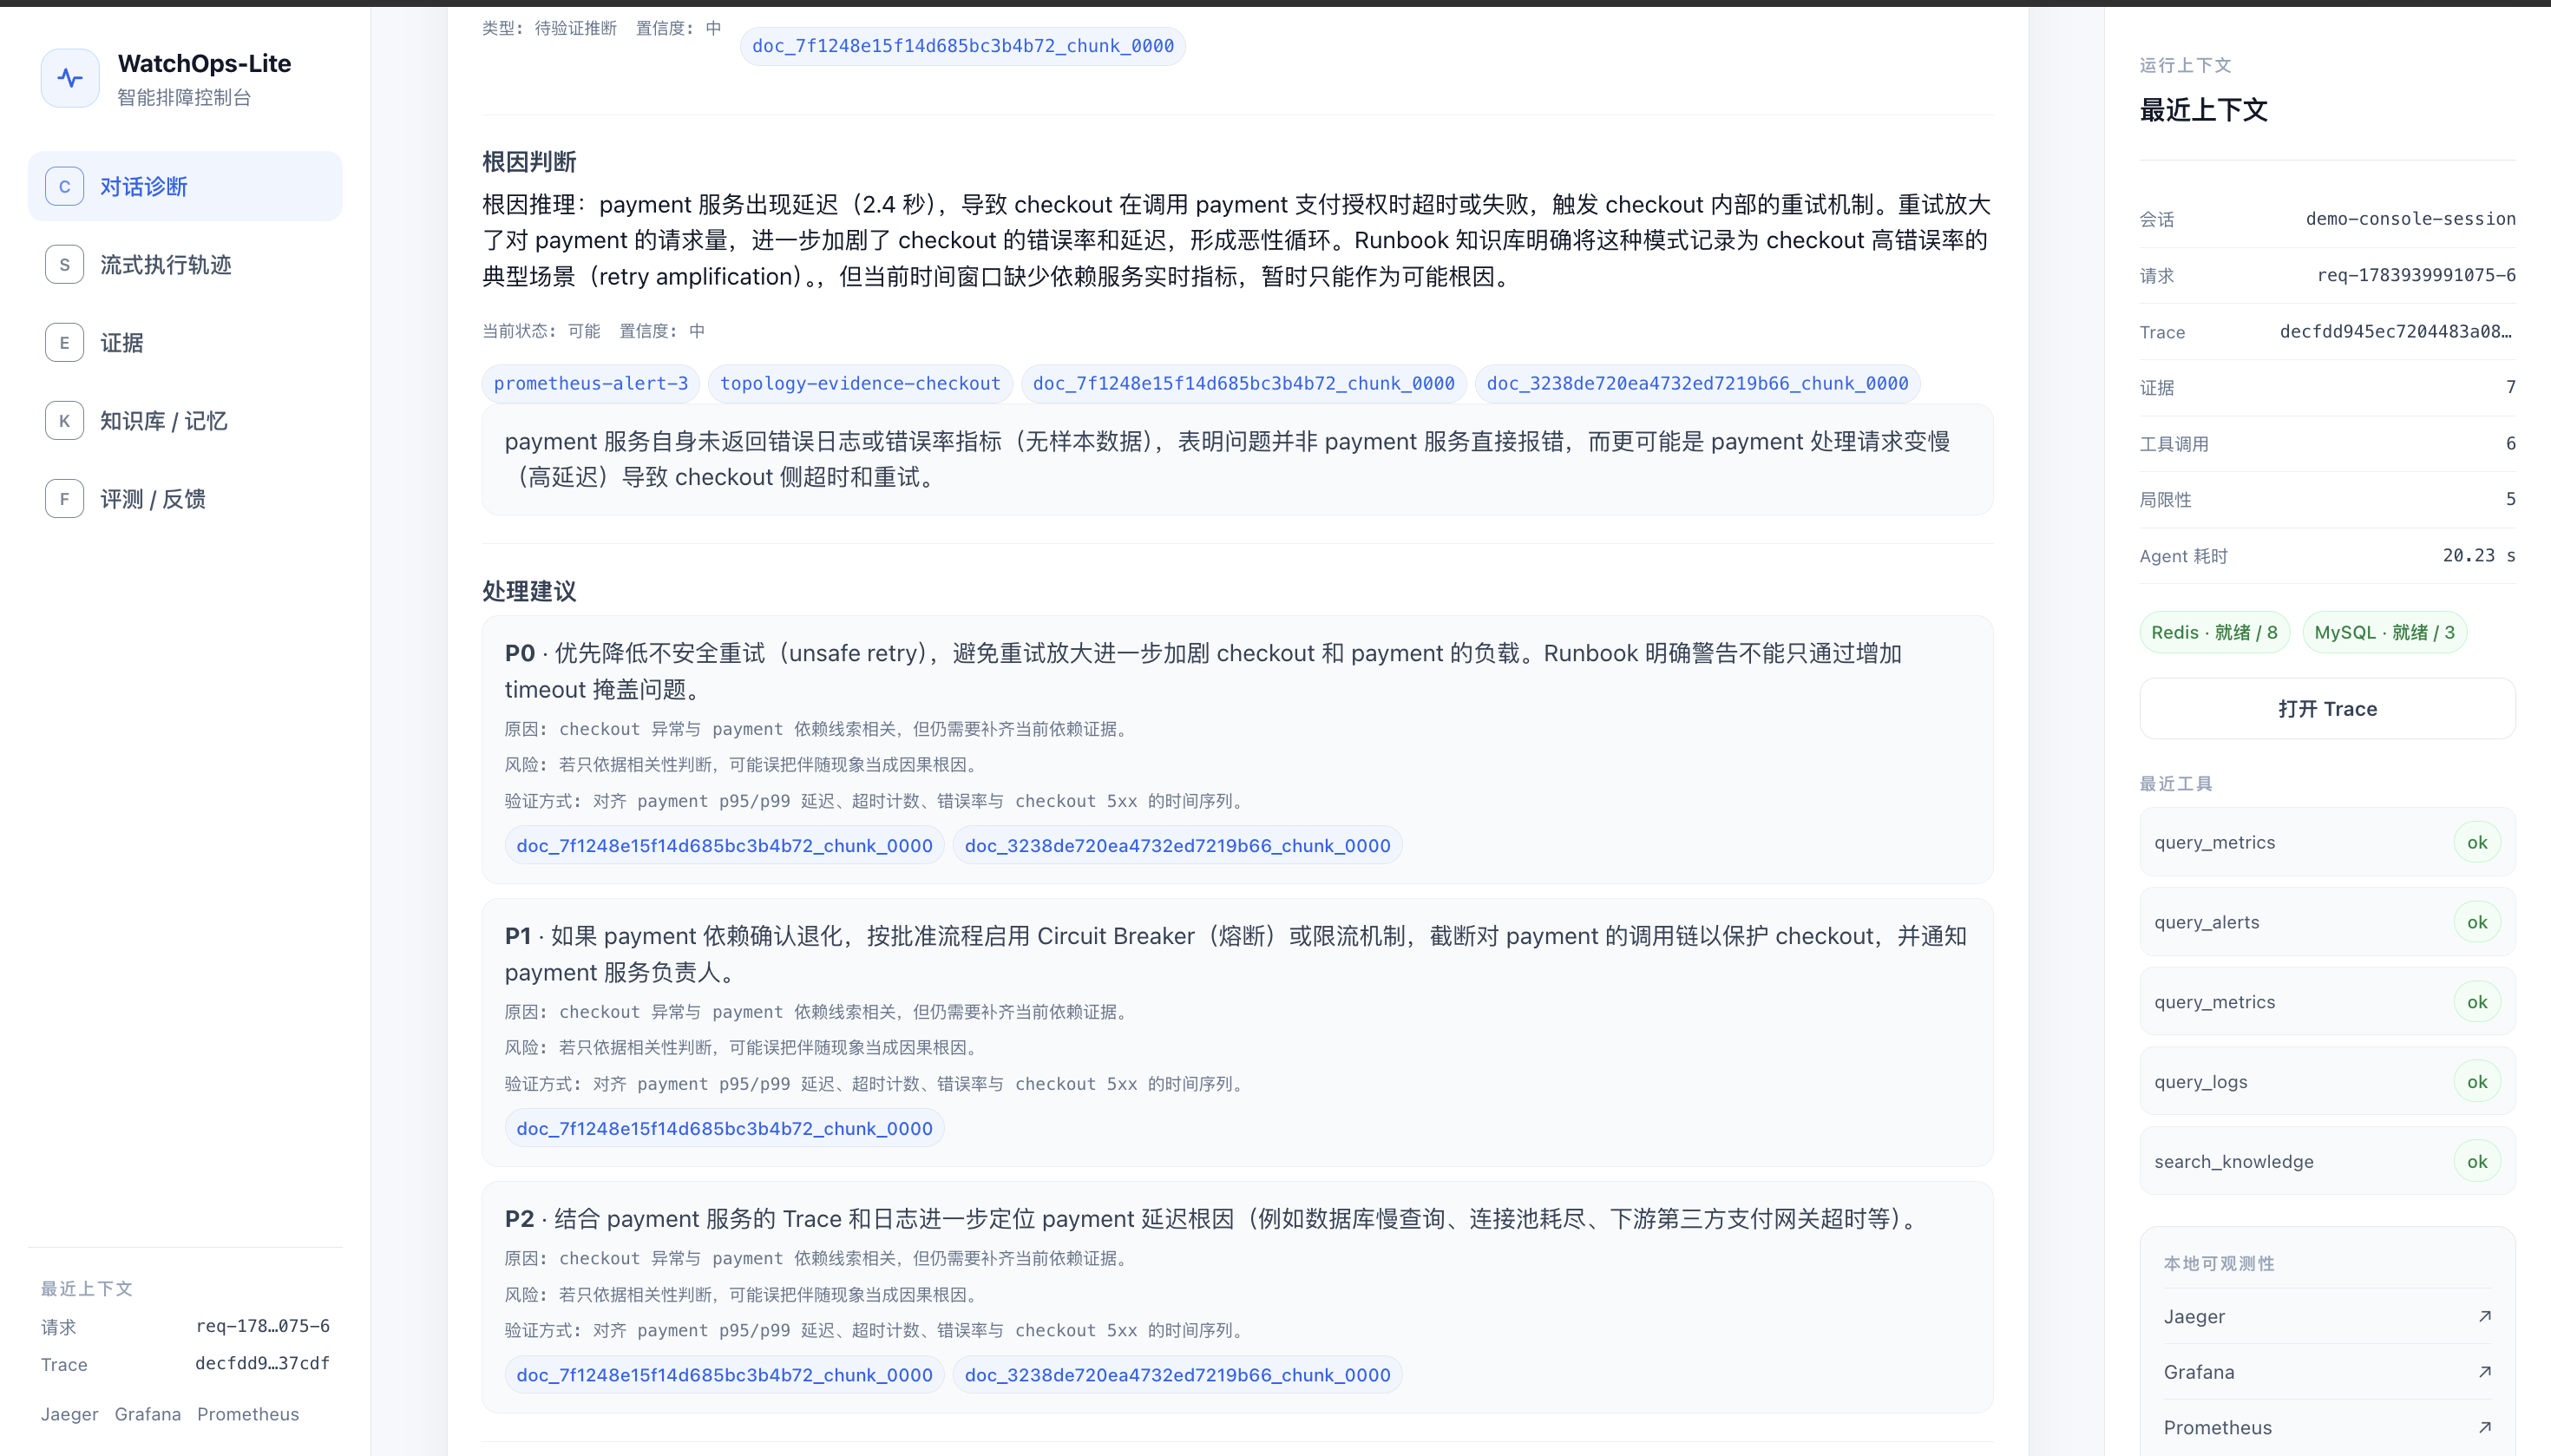
如何验证,以及做到哪里
意图与检索
检查 Intent、Slot、Clarify 决策,以及召回结果、Recall@5、MRR 和多查询的收益。
Agent 与 Evidence
评测工具选择、调用参数、证据覆盖、引用白名单和降级;离线用例不依赖真实模型或外部观测服务。
回放与观测
Bad Case 保存稳定的失败检查,比较修复、仍失败与新失败;OpenTelemetry 和指标覆盖执行链路。
当前实现边界
所有诊断工具只读,系统不自动执行修复。单 Agent 与多 Agent 通过不同接口和控制台入口使用,意图识别不负责自动切换两种模式。默认确定性运行方式与需要模型配置的 Eino ReAct 路径有明确区分。
Realtime Collab Editor
分布式实时协同代码编辑器